새로운 Python Package Manager

uv 의 목적

uv는 Rust로 작성된 고속 의존성 해석 엔진을 앞세워, 가상환경 생성, 의존성 관리, 파이썬 버전 관리, 패키징, 포매터/린터 같은 서드파티 도구 실행을 한번에 알잘딱 처리합니다.

  1. A single tool to replace pip, pip-tools, pipx, poetry, pyenv, twine, virtualenv, and more.
  2. 10-100x faster than pip.
  3. Cargo-style workspaces
  4. Supports macOS, Linux, and Windows.
  5. https://github.com/astral-sh/uv

Cargo-style workspaces

독립적인 공간의 의존성, 가상환경, 패키지 관리를 할 수 있다.

  • pyenv, virtualenv 등의 가상환경 구성후 프로젝트에서 사용하는 방식이 아니다.
  • 프로젝트 공간에 의존성, 가상환경 등을 직접 구성한다.
  • venv 를 각 프로젝트 폴더에서 관리한다.

Python 패키징이 복잡해진 역사

https://www.reddit.com/r/Python/comments/cry1fn/rant_after_going_through_literal_hell_with/

  1. 초기 시절: easy_install
    2000년대 후반~2010년대 초반에는 PyPI와 pip 가 지금처럼 성숙하지 않았습니다.
    당시에는 easy_install 이 사실상 유일한 선택지였고, 설치한 패키지를 제거하거나, 설치된 패키지 버전을 지정·고정하는 기능이 부족해 많은 불편이 있었습니다.

  2. pip의 등장
    pip는 requirements.txt를 통해 의존성을 고정하고 설치할 수 있는 기능을 제공하면서, 그야말로 Python 커뮤니티의 표준이 되었습니다.
    Python 공식 배포판에도 점차 포함되어 사실상 “파이썬 하면 pip”라는 인식이 굳어지기도 했습니다.

  3. conda의 등장과 머신러닝 생태계
    conda는 주로 NumPy, SciPy 같은 과학 컴퓨팅 라이브러리를 쉽게 설치하고자 하는 목적에서 개발되었습니다.
    하지만 conda 는 별도의 패키지 저장소(Anaconda Cloud, conda-forge)를 사용하고, pip 와는 분리된 자체 의존성 해석 방식, 가상환경 관리 방식을 채택하고 있어서 생태계가 이원화되는 문제를 야기했습니다.
    그 결과, 리서쳐와 서비스 개발자 간의 소통 문제가 빈번히 발생해 왔습니다.

  4. poetry의 부상
    poetry는 pyproject.toml과 poetry.lock 기반으로 의존성을 엄격히 고정하고, 여러 플랫폼에서 재현 가능한 빌드를 제공한다는 점에서 각광을 받았습니다.

단점으로는, 복잡한 의존성을 가진 프로젝트에서 해석 속도가 느리다는 점이 종종 지적되었습니다.

그럼에도 Poetry는 “제대로 동작하는 것을 보장한다” 는 확실한 장점을 가진 덕분에, 비교적 규모가 큰 팀이나 오픈소스 프로젝트에서 널리 채택되었습니다.

  1. 기타 pyenv 등.
    pyenv, pipx, pipenv, pip-tools 등의 도구도 각자 가상환경·의존성 관리, Python 버전 관리, 종속성 락(lock) 파일 관리 등 다양한 문제를 해결하고자 시도했습니다.

하지만 이런 도구마다 관점이 달라서, 서로 비슷한 기능이 겹치거나, 설정 방식이 달라 숙련된 개발자조차 혼란스러워하는 지점이 많았습니다.

Installation

Install uv with our standalone installers:

1
2
# On macOS and Linux.
curl -LsSf https://astral.sh/uv/install.sh | sh
1
2
# On Windows.
powershell -ExecutionPolicy ByPass -c "irm https://astral.sh/uv/install.ps1 | iex"

from PyPI:

1
2
3
4
5
# With pip.
pip install uv

# Or pipx.
pipx install uv

설치후 self update

1
uv self update

Uninstall

1
2
3
4
# Remove all data that uv has stored
uv cache clean
rm -r "$(uv python dir)"
rm -r "$(uv tool dir)"
1
2
# Remove binaries
rm ~/.local/bin/uv ~/.local/bin/uvx

사용방법

  1. 가상환경을 만들고 이를 이용하는 방법
  2. 프로젝트 폴더별로 가상화경만 이용하는 방법
  3. 프로젝트에서 pyproject.toml 의존성을 이용하는 방법

Python version

uv 에서 standalone 으로 python 을 설치하고 변경할 수 있다.

원하는 폴더에서 .python-version 파일의 버전으로 파이썬을 실행할 수 있다.

standalone python 을 설치한다.

1
uv python install 3.10 3.11 3.12

가상환경 사용하기

https://docs.astral.sh/uv/pip/environments/

https://earthly.dev/blog/python-uv/

새로운 가상환경 만들기

기존 프로젝트/폴더에서 사용하던 requirements.txt 준비한다.

  1. 프로젝트 폴더에서 uv 프로젝트 초기화
  2. 의존성 requirements.txt 설치
1
2
mkdir my_uv_project
uv venv my_env -p 3.13

활성화

1
2
3
4
5
# window
./my_env/scripts/activate

# linux & macos
source ./my_env/bin/activate
1
2
3
4
5
FOLDER/
├── .python-version
├── .gitignore
├── pyproject.toml
└── README.md

가상환경에서 uv pip 명령으로 패키지를 설치하고 관리할 수 있다.

하지만 호환을 위해 pip 를 사용해야할 경우도 많기 때문에 pip 를 설치해 준다.

1
2
3
4
(my_env)> uv pip install pip
Resolved 1 package in 77ms
Prepared 1 package in 362ms
Installed 1 package in 589ms

폴더별 가상환경을 만들어 사용한다.

특정 디렉토리에서 pin 명령으로 python 버전을 지정할 수 있다.

  • 여기서 A, B 디렉토리를 만들고 3.10, 3.11를 지정해 사용해 보겠다.
1
2
3
4
5
6
7
8
9
10
11
12
13
mkdir A
mkdir B

cd A
uv venv -p 3.10
Using CPython 3.10.16
Creating virtual environment at: .venv
Activate with: .venv\Scripts\activate

PS D:\A> .\.venv\Scripts\activate
(A) PS D:\A>
(A) PS D:\A> deactivate
PS D:\A>

B 폴더에서 가상환경을 만든다

1
2
3
4
5
6
7
8
9
cd ../B
> uv venv -p 3.11
Using CPython 3.11.11
Creating virtual environment at: .venv
Activate with: .venv\Scripts\activate
PS D:\B> .\.venv\Scripts\activate
(B) PS D:\B>
(B) PS D:\B> deactivate
PS D:\B>

여러 가상환경을 만들어 사용

한 프로젝트 폴더에 여러개의 가상환경을 만들어 사용할 수 있다.

기존 가상환경에서 새로운 가상환경을 추가해 서로 교화하며 사용할 수 있다.

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
# 새 가상환경 생성
(A) PS D:\A> uv venv .second_env -p 3.12
Using CPython 3.12.9
Creating virtual environment at: .second_env
Activate with: .second_env\Scripts\activate

# second_env 활성화
(A) PS D:\A> .\.second_env\Scripts\activate
(.second_env) PS D:\A> python -V
Python 3.12.9

# .venv 활성화
(.second_env) PS D:\A> .\.venv\Scripts\activate
(A) PS D:\A> python -V
Python 3.10.16
(A) PS D:\A>```


# 프로젝트 의존성 이용하기

기존 프로젝트/폴더에서 사용하던 requirements.txt 준비한다.

1. 프로젝트 폴더에서 uv 프로젝트 초기화
3. 의존성 requirements.txt 설치
1. 의존성 추가하면 자동으로 .venv 가상환경이 생성된다.

진행한 후 폴더에 다음 파일이 추가된다

FOLDER/
├── .venv
├── .python-version
├── .gitignore
├── pyproject.toml
└── README.md

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20


1. 프로젝트 초기화

```powershell
# 프로젝트 폴더
> cd My-lectures

> uv init
Initialized project `My-lectures`


2. 의존성 설치

```powershell
> uv add -r .\requirements.txt
Resolved 156 packages in 880ms
Prepared 36 packages in 39.36s
Installed 36 packages in 39.04s
  1. 가상환경 활성화
1
2
> .\.venv\Scripts\activate
(My-lectures) PS D:\My_Lectures>
  1. IDE 에서 .venv 를 인식한다

동일한 .venv 가상 환경을 IDE가 바로 인식할 수 있다.

uv add –dev ipykernel # 개발용(인터랙티브) 의존성 추가

프로젝트 python 버전 변경

uv sync로 프로젝트에 필요한 Python 버전과 .venv 가 자동으로 맞춰진다.

앞의 My-lectures 폴더를 대상으로 변경해 보자.

  1. pyproject.toml 의 python 버전을 변경
  2. uv python pin 명령
  3. uv sync

의존성 python 버전을 변경하려면 pyproject.toml 를 수정해야 한다.

1
2
3
4
5
6
7
[project]
name = "jupyter-lectures"
version = "0.1.0"
description = "Add your description here"
readme = "README.md"
requires-python = ">=3.13"
dependencies = []

3.12로 변경해 보자

1
requires-python = ">=3.12"

pin 으로 버전을 변경한다

1
> uv python pin 3.12

uv sync 로 pyproject.toml 의 의존성을 .venv 에 업데이트 한다.

1
2
3
4
5
6
7
> uv sync
Using CPython 3.12.9
Removed virtual environment at: .venv
Creating virtual environment at: .venv
Resolved 171 packages in 764ms
Prepared 25 packages in 13.32s
Installed 166 packages in 28.90s

uv pip 사용

pip 는 uv 명령으로 사용하면 된다.

1
uv pip

Project 사용

https://docs.astral.sh/uv/guides/projects/

https://sigridjin.medium.com/%ED%8C%8C%EC%9D%B4%EC%8D%AC-%EA%B0%9C%EB%B0%9C%EC%9E%90%EB%9D%BC%EB%A9%B4-uv-%EB%A5%BC-%EC%82%AC%EC%9A%A9%ED%95%A9%EC%8B%9C%EB%8B%A4-546d523f7178

zipline-reloaded 빌드환경

zipline 은 Quantopian 이 운영하던 오픈소스 백테스팅 으로 2021년경 지원이 중단된 뒤로 Machine Learning for Trading 책의 저자가 fork 한 zipline-reloaded 프로젝트로 유지되고 있다.

오픈소스 개발에 참여하기 위해서 링크의 개발환경이 갖춰져야 한다.

개발환경 구성하기

https://zipline.ml4trading.io/development-guidelines.html

  1. python 3.12
  2. venv, pyenv, conda 등 가상환경 가능.

Linux 의존성 설치

컴파일을 위해서 리눅스 패키지 의존성을 설치한다.

1
sudo apt install libatlas-base-dev gfortran pkg-config libfreetype6-dev hdf5-tools

ta-lib 의존성

zipline 에는 ta-lib 를 사용하는데 C 기반의 컴파일이 필요하다.

  • linux / macos

ta-lib C library 설치가 된후에 파이썬 모듈을 설치한다.

1
sudo apt install ta-lib

numpy, sphinx, Cython 설치

1
pip install -U numpy Cython 

필요 모듈 설치하기

setuptools/build 설치

1
pip install -U setuptools wheel twine build

빌드

1
python -m build

dist 폴더에 .wheel 결과가 생성된다. 이 whl 을 설치한다

~/zipline-reloaded$ pip install dist/zipline_reloaded-3.0.3-cp311-cp311-linux_x86_64.whl

doc 빌드

sphinx 관련

1
pip install -U sphinx m2r2 sphinx_markdown_tables

cd docs

zipline-reloaded 1 - 설치

zipline 은 Quantopian 이 운영하던 오픈소스 백테스팅 으로 2021년경 지원이 중단된 뒤로 Machine Learning for Trading 책의 저자가 fork 한 zipline-reloaded 프로젝트로 유지되고 있다.

zipline 이란

  • zipline 은 Quantopian 이 운영하던 오픈소스 백테스팅이다.
  • 2021년경 업데이트 지원이 중단된 상태이다.
  • 여기서는 fork 중 Machine Learning for Trading 책의 저자 fork이 zipline-reloaded 프로젝트를 선택한다.

zipline의 fork 버전인 zipline-reload 를 설치하고 zipline은 bundle 를 통해서 데이터를 받아서 알고리즘을 실행하는 구조로 보이다. 여기서는 기본 번들로 사용하는 quandl 설치까지만 진행한다.

zipline 설치

zipline-reload 를 설치한다.

1
2
3
4
5
6
# pip
pip install zipline-reloaded


# conda
conda install -c conda-forge zipline-reloaded

quandl 시세 데이터 설치

기본 데이터 번들 Ziplin 을 위한 데이터: https://zipline.ml4trading.io/bundles.html

zipline은 기본 번들로 quandl 의 wiki 데이터 세트를 제공한다. Quandl 데이터 번들에는 자산의 일일 가격 데이터, 분할, 현금 배당금 및 자산 메타데이터가 포함됩니다.

Quandl은 2018년 초에 이 데이터 세트를 중단했으며 더 이상 업데이트되지 않습니다. 그럼에도 불구하고 자체 데이터 세트를 설정하지 않고 Zipline을 시험해 보는 것은 유용한 시작점입니다.

현재 quandl 데이터는 NASDAQ 에서 호스팅한다. 설치시 NASDAQ 에 가입해 설치를 했어야 한다.

Get a QUANDL API Key

*Ingest Zipline Bundle 을 다운받으려면 data.nasdaq.com에 가입해서 API key 를 얻는다. account setting 에 API Key 가 있다.

https://data.nasdaq.com/account/profile

Zipline 기본 Bundle

API key 를 복사해서 quandl 데이터 번들을 다운로드 하려면 zipline 명령으로 시작한다.

다음 명령 중 하나를 사용하면 기본 quandl 번들을 홈디렉토리에 다운로드 한다.

1
2
3
4
5
$ QUANDL_API_KEY='**********'  zipline ingest -b quandl

or

$ QUANDL_API_KEY='**********' zipline ingest

다운로드 되는 번들 파일은 사용자 홈디렉토리 아래 .zipline/data 폴더에 저장된다.

Jupyter Notebook 셀에서 실행한다면

! 다음에 명령을 넣어 주면 된다.

1
$ ! QUANDL_API_KEY='**********' zipline bundles

다운로드한 번들을 확인할 수 있다.

1
2
3
4
5
6
7
$ zipline bundles

csvdir <no ingestions>
quandl 2024-02-03 12:59:38.882421
quandl 2024-02-03 12:55:18.326897
quandl 2024-02-03 12:42:14.980288
quantopian-quandl <no ingestions>

zipline 으로 알고리즘 실행

zipline 은 3가지 방법으로 알고리즘을 실행할 수 있다. run 명령 도움말을 참조할 수 있다.

1
$ zipline run --help

기본 번들에 있는 자산의 가격 데이터를 사용해서 zipline 알고리즘을 실행해 보자.

Python - 문서화 도구 Sphinx

Sphinx 는 python의 대표적인 문서화 도구로 reStructedText 또는 Markdown 문서를 HTML, pdf, man page 등의 결과물로 생성할 수 있다.

sphinx 설치

sphinx 는 python 환경에서 실행이 된다. 설치는 python 환경 혹은 OS 환경에 직접 설치하는 방법이 있다. 파이썬 가상환경을 권장한다.

https://www.sphinx-doc.org/en/master/usage/installation.html

- Python 환경에 설치

python 환경 혹은 python 가상환경 (venv, virtualenv 등)에 설치

pip

1
pip install sphinx

Anaconda

1
conda install sphinx

- 시스템에 직접 설치

각 OS 의 SW 로 설치한다면 package 관리자를 사용해 설치한다.

Debian/Ubuntu

1
apt install python3-sphinx

RHEL, CentOS

1
yum install python-sphinx

macOS / home-brew

1
brew install sphinx-doc

Pandas - Pivot, Stack, Unstack, Melt

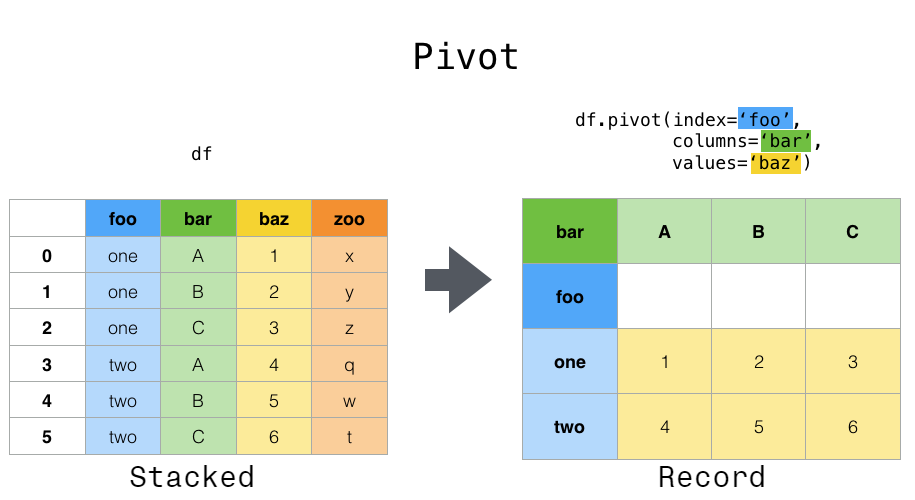
Pandas 에서 2차원 data를 Stack, unstack, melt 를 이용해 복합 인덱스를 사용할 수 있고 Pivot 을 이용해 특정 데이터 중심의 2차원 데이터로 생성할 수 있다.

  1. Pivot
  2. Stack & Unstack
  3. Melt
1
2
import pandas as pd
import numpy as np

2차원 테이블

행과 열로 구성된 데이터 집합

1
2
3
4
5
6
7
df = pd.DataFrame(
{'foo' : ['One','One','One','Two','Two','Two'],
'bar': ['A','B','C','A','B','C'],
'baz': [1,2,3,4,5,6] ,
'zoo': ['x','y','z','q','w','t']}
)
df

foo bar baz zoo
0 One A 1 x
1 One B 2 y
2 One C 3 z
3 Two A 4 q
4 Two B 5 w
5 Two C 6 t

Pivot

피봇/피봇 테이블은 2차원 데이터 열에서 공통된 부분을 중심으로 새 테이블 집합을 형성하게 해준다. 피봇은 index, columns, values 라는 이름을 가진 세 가지 parameter를 취한다. 이러한 각 파라미터의 값으로 원래 표에 열 이름을 지정해야 한다.

foo, bar, baz, zoo 컬럼 중에서 foo 에 대해서 정리를 하고 bar 를 컬럼으로 지정하면 아래와 같다.

1
2
df_pivot = df.pivot_table(index='foo', columns='bar', values='baz')
df_pivot

bar A B C
foo
One 1 2 3
Two 4 5 6

ex) nba 데이터를 포지션의 연령별 연봉 테이블로 전환

1
2
dfnba = pd.read_csv('../data/nba.csv')
dfnba

Name Team Number Position Age Height Weight College Salary
0 Avery Bradley Boston Celtics 0.0 PG 25.0 6-2 180.0 Texas 7730337.0
1 Jae Crowder Boston Celtics 99.0 SF 25.0 6-6 235.0 Marquette 6796117.0
2 John Holland Boston Celtics 30.0 SG 27.0 6-5 205.0 Boston University NaN
3 R.J. Hunter Boston Celtics 28.0 SG 22.0 6-5 185.0 Georgia State 1148640.0
4 Jonas Jerebko Boston Celtics 8.0 PF 29.0 6-10 231.0 NaN 5000000.0
... ... ... ... ... ... ... ... ... ...
453 Shelvin Mack Utah Jazz 8.0 PG 26.0 6-3 203.0 Butler 2433333.0
454 Raul Neto Utah Jazz 25.0 PG 24.0 6-1 179.0 NaN 900000.0
455 Tibor Pleiss Utah Jazz 21.0 C 26.0 7-3 256.0 NaN 2900000.0
456 Jeff Withey Utah Jazz 24.0 C 26.0 7-0 231.0 Kansas 947276.0
457 NaN NaN NaN NaN NaN NaN NaN NaN NaN

458 rows × 9 columns

1
pd.options.display.float_format = "{:,.2f}".format

컬럼의 데이터에 공통된 모습이 많이 보인다. 이 중에서 포지션을 기준으로 나이에 따른 연봉을 본다고 가정하면 포지션을 인덱스로하고 나이를 컬럼으로 지정하면 아래와 같다.

1
2
# 포지션의 연령별 연봉 테이블
dfnba.pivot_table(index='Position', columns='Age', values='Salary')

Age 19.00 20.00 21.00 22.00 23.00 24.00 25.00 26.00 27.00 28.00 ... 31.00 32.00 33.00 34.00 35.00 36.00 37.00 38.00 39.00 40.00
Position
C NaN 5,143,140.00 1,571,000.00 3,476,698.20 2,121,999.50 4,532,003.33 10,881,995.00 3,041,850.82 5,004,260.50 7,635,761.83 ... 10,338,218.00 8,208,695.50 9,500,000.00 6,258,000.00 7,448,760.00 947,276.00 NaN 222,888.00 NaN 5,250,000.00
PF NaN 2,369,838.00 2,397,408.00 1,601,105.80 2,399,120.50 2,577,551.44 2,195,476.60 7,228,086.75 9,217,098.43 5,268,839.17 ... 5,323,787.00 14,346,365.00 2,630,241.40 6,469,277.50 2,624,593.50 2,877,470.00 6,666,667.00 NaN NaN 8,500,000.00
PG NaN 3,316,290.00 1,944,080.00 2,381,130.00 1,627,769.00 4,652,526.50 5,422,085.80 10,038,174.80 5,944,070.17 5,021,965.17 ... 7,467,596.40 4,082,425.33 2,226,179.67 8,395,104.00 NaN 2,170,465.00 NaN NaN 947,726.00 250,750.00
SF NaN 1,979,976.00 1,404,480.00 2,401,364.60 2,760,134.36 5,067,491.60 3,382,640.73 7,322,325.20 10,532,567.00 1,996,608.71 ... 10,960,320.25 9,720,195.75 NaN 261,894.00 947,276.00 1,721,559.75 25,000,000.00 3,376,000.00 NaN NaN
SG 1,930,440.00 1,749,840.00 2,215,710.43 2,055,241.00 1,388,251.18 3,205,720.53 1,782,834.89 9,872,690.29 4,815,524.62 6,354,000.00 ... 7,085,000.00 2,041,138.00 2,233,533.33 12,579,269.50 3,512,173.75 3,311,138.00 NaN 1,880,638.00 4,088,019.00 NaN

5 rows × 22 columns

Stack & Unstack

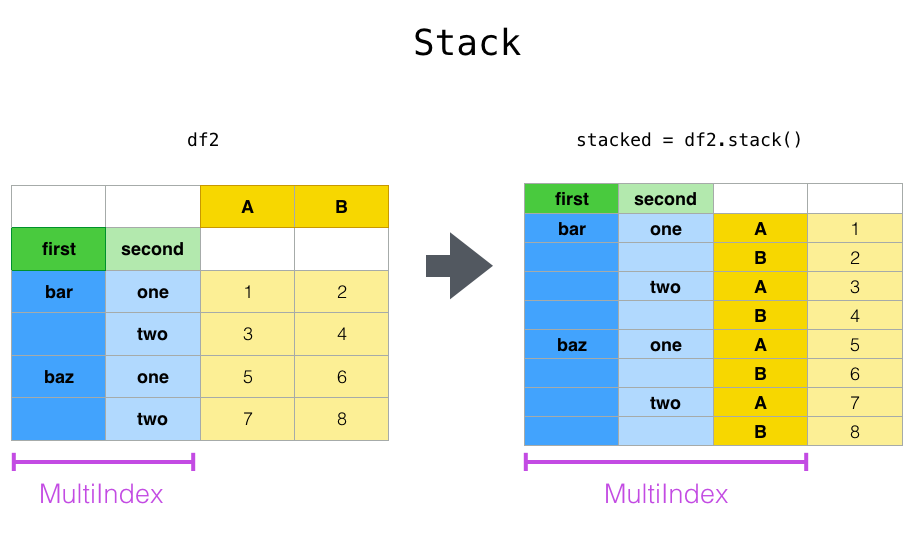
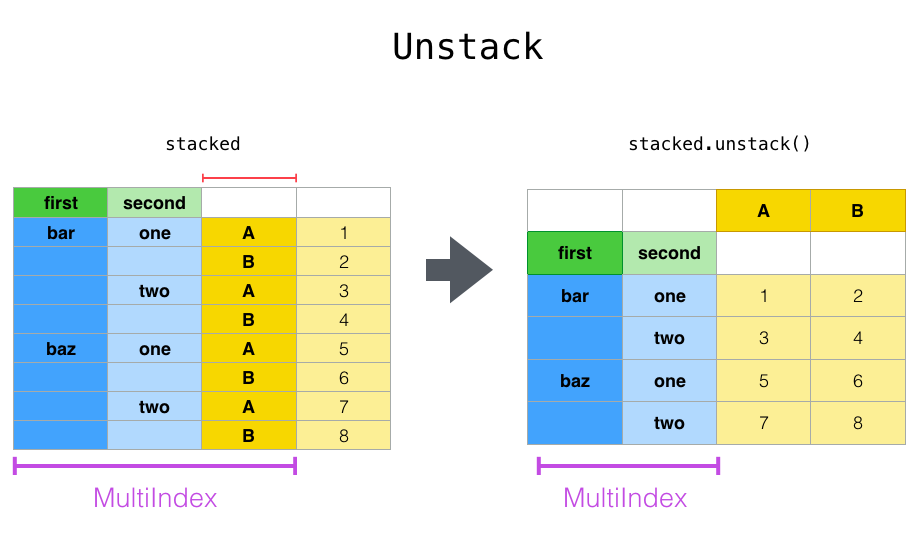
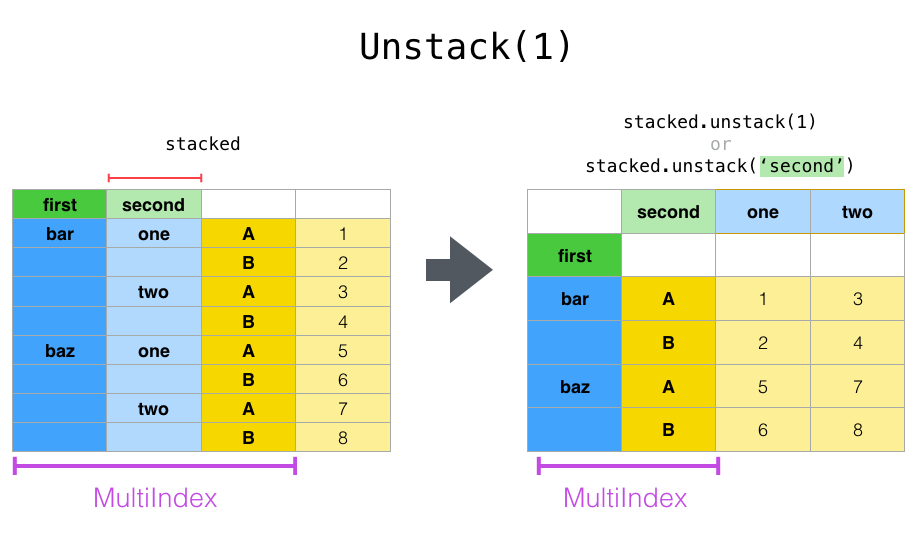
2차원 테이블은 행 과 열이 순차적 값으로 교차하게 되어 있다. 스택은 컬럼의 값을 아래-위로 배치를 시킨다고 상상이 된다. 그래서 스택과 언스택은 이렇게 생각된다.

  • stack : 2차원 컬럼의 내용을 수직방향으로 쌓는 구조, 즉 새로운 인덱스가 더해진다.
  • unstack : 인덱스 구성요소를 한 단계 컬럼으로 만들며 수평방향으로 쌓게 한다.

stack

pandas reshaping

1
2
3
4
5
6
7
df_single_level = pd.DataFrame(
[['Mostly cloudy', 10], ['Sunny', 12]],
index=['London', 'Oxford'],
columns=['Weather', 'Wind']
)
df_single_level

Weather Wind
London Mostly cloudy 10
Oxford Sunny 12

index와 weather, wind 라는 컬럼을 stack을 호출하면 weather-wind 관련 인덱스를 생성하고 데이터를 나열한다.

1
df_single_level.stack()
London  Weather    Mostly cloudy
        Wind                  10
Oxford  Weather            Sunny
        Wind                  12
dtype: object

다른 데이터를 살펴보자.

1
2
3
4
5
6
7
8
9
10
11
12
# MultiIndex
tuples = list(
zip(
*[
["bar", "bar", "baz", "baz", "foo", "foo", "qux", "qux"],
["one", "two", "one", "two", "one", "two", "one", "two"],
]
)
)
index = pd.MultiIndex.from_tuples(tuples, names=["first", "second"])
df = pd.DataFrame(np.random.randn(8, 2), index=index, columns=["A", "B"])
df

A B
first second
bar one -1.301694 -0.013259
two -0.197846 0.879890
baz one 0.718211 -0.739434
two -0.140217 0.071260
foo one -1.142268 -2.606413
two 1.119145 0.109402
qux one -0.504167 -1.703280
two 1.064976 1.011060

위 데이터는 stack()을 하면 A, B 컬럼이 MultiIndex 로 추가되며 A, B 컬럼 데이터 포인트가 배치된다.

1
df.stack()
first  second   
bar    one     A   -1.301694
               B   -0.013259
       two     A   -0.197846
               B    0.879890
baz    one     A    0.718211
               B   -0.739434
       two     A   -0.140217
               B    0.071260
foo    one     A   -1.142268
               B   -2.606413
       two     A    1.119145
               B    0.109402
qux    one     A   -0.504167
               B   -1.703280
       two     A    1.064976
               B    1.011060
dtype: float64
1
2
df2 = df[:4]
df2

A B
first second
bar one -1.301694 -0.013259
two -0.197846 0.879890
baz one 0.718211 -0.739434
two -0.140217 0.071260
1
2
stacked = df2.stack()
stacked
first  second   
bar    one     A   -1.301694
               B   -0.013259
       two     A   -0.197846
               B    0.879890
baz    one     A    0.718211
               B   -0.739434
       two     A   -0.140217
               B    0.071260
dtype: float64

Unstack

pandas reshaping

1
stacked
first  second   
bar    one     A   -1.301694
               B   -0.013259
       two     A   -0.197846
               B    0.879890
baz    one     A    0.718211
               B   -0.739434
       two     A   -0.140217
               B    0.071260
dtype: float64
1
stacked.unstack()

A B
first second
bar one -1.301694 -0.013259
two -0.197846 0.879890
baz one 0.718211 -0.739434
two -0.140217 0.071260

레벨을 지정

1
stacked.unstack(1)

second one two
first
bar A -1.301694 -0.197846
B -0.013259 0.879890
baz A 0.718211 -0.140217
B -0.739434 0.071260
1
stacked.unstack(2)

A B
first second
bar one -1.301694 -0.013259
two -0.197846 0.879890
baz one 0.718211 -0.739434
two -0.140217 0.071260
1

Melt

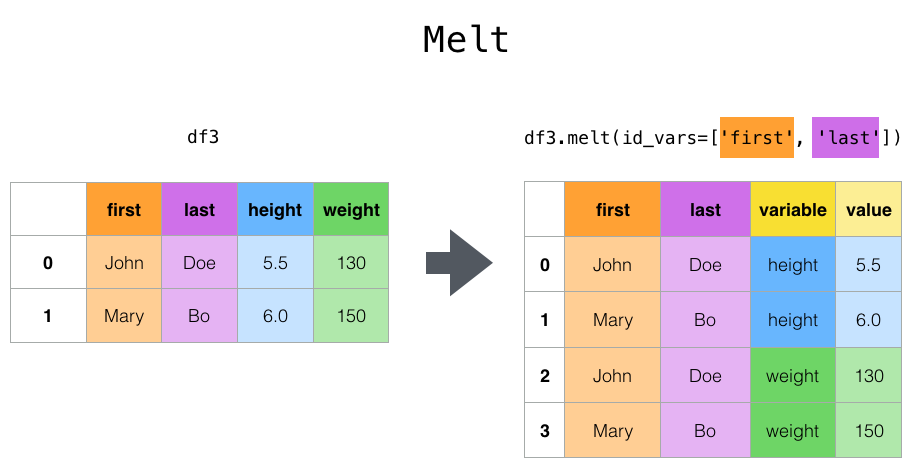
melt() 는 ID 변수를 기준으로 원래 데이터셋에 있던 여러개의 칼럼 이름을 ‘variable’ 칼럼에 위에서 아래로 길게 쌓아놓고, ‘value’ 칼럼에 ID와 variable에 해당하는 값을 넣어주는 식으로 데이터를 재구조화합니다.

1
2
3
4
5
6
7
8
9
cheese = pd.DataFrame(
{
"first": ["John", "Mary"],
"last": ["Doe", "Bo"],
"height": [5.5, 6.0],
"weight": [130, 150],
}
)
cheese

first last height weight
0 John Doe 5.50 130
1 Mary Bo 6.00 150
1
2
# colums중 height, weight 를 row 로 융합
cheese.melt(id_vars=['first','last']) # first, last 인덱스로 나머지 컬럼은 value 로 치환

first last variable value
0 John Doe height 5.50
1 Mary Bo height 6.00
2 John Doe weight 130.00
3 Mary Bo weight 150.00
1
cheese.melt(id_vars=['first','last'], value_name='quantity') 

first last variable quantity
0 John Doe height 5.50
1 Mary Bo height 6.00
2 John Doe weight 130.00
3 Mary Bo weight 150.00
1

참고

  1. pandas.DataFrame.stack

Pandas/Numpy 숫자의 출력 옵션 조정

numpy 와 pandas 에서 수를 출력할 때 형식, 크기 및 범위를 설정할 수 있다. 간단히 보면 아래 테이블 같이 형식을 바꿔준다.

column 변환 column
1e6 precision 1,000,000
1.1e-6 format 0.1

아래 요약한 옵션 방법을 사용해서 Numpy 와 Pandas에 있는 숫자를 출력할 때 표현방법, 표기법, 환률, 정밀도 등을 변경해 사용할 수 있다

numpy 출력 형식 변경

numpy 숫자 출력 형식 변경

numpy.set_printoptions 을 사용할 수 있다.

1
2
numpy.set_printoptions(precision=None, threshold=None, edgeitems=None, linewidth=None, suppress=None,
nanstr=None, infstr=None, formatter=None, sign=None, floatmode=None, *, legacy=None)

현재 출력형식 확인

np.get_printoptions() 으로 현재 상태를 출력할 수 있다.

1
2
3
4
5
6
7
8
9
10
11
12
13
> np.get_printoptions()
{'edgeitems': 3,
'threshold': 1000,
'floatmode': 'maxprec',
'precision': 8,
'suppress': False,
'linewidth': 75,
'nanstr': 'nan',
'infstr': 'inf',
'sign': '-',
'formatter': None,
'legacy': False
}

Numpy 에서 실수 Float 의 출력 형식을 바꾸는 몇가지 사례를 보자

- formatter 이용

1
2
import numpy as np
np.set_printoptions(formatter={'float_kind': lambda x: "{0:0.3f}".format(x)})

- precision 이용

1
2
3
> np.set_printoptions(precision=4)
> np.array([1.123456789])
[1.1235]

- threshold 이용

개수가 많은 아이템을 출력할 때 요약해 출력할 수 있다.

1
2
3
> np.set_printoptions(threshold=5)
> np.arange(10)
array([0, 1, 2, ..., 7, 8, 9])

numpy.printoptions 사용

numpy.printoptions 를 with 구문과 함께 사용해 제한된 출력 조정을 할 수 있다.

출력시 printoptions 를 with 구문과 사용할 수 있다. set_printoptions 의 인자를 동일하게 적용할 수 있다

  • precision, threshold, edgeitems, linewidth, suppress, nanstr, infstr, formatter, sign, floatmode
1
numpy.printoptions(*args, **kwargs)[source]

소수점 출력 변경

1
2
3
4
5
6
> np.array([2.0]) / 3
array([0.66666667])


> with np.printoptions(precision=3):
> print( np.array([2.0]) / 3 )

pandas 숫자 출력 형식 변경

pandas에서 몇 가지 옵션을 바꾸는 방법을 정리해 보자. pandas의 옵션은 pd.options 를 사용한다.

pd.options.display

출력의 형태, 표기를 변경하는 것은 pd.options.display 아래에 있다. 여기서 사용할 수 있는 옵션은 describe_option() 으로 확인할 수 있다.

1
2
3
4
5
6
7
> pd.describe_option()
compute.use_bottleneck : bool
Use the bottleneck library to accelerate if it is installed,
the default is True
Valid values: False,True
[default: True] [currently: True]
...

- row, column 출력 개수 조정

  • pd.options.display.max_rows : 표를 출력할 때 최대 행 수입니다.
  • pd.options.display.min_rows : 표를 출력할 때 최소 행 수입니다.
1
2
3
4
5
import pandas as pd
> pd.options.display.max_rows
60
> pd.options.display.min_rows
10

min_row, max_row에 직접 대입하면 해당 옵션의 현재 값이 변경된다.

1
2
3
> pd.options.display.min_rows=100
> pd.options.display.min_rows
100

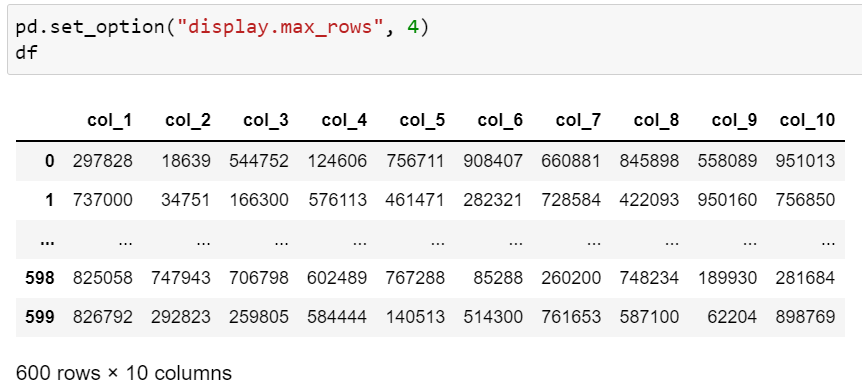
max_rows에 값을 입력하면 테이블의 최대 행수를 바꿀 수 있다.

이미지 참조 1

1
2
3
> pd.options.display.max_rows = 100
> pd.options.display.max_rows
100

- pd.get_option(), pd.set_option() 함수

pd.get_option() 함수를 이용해서 옵션인자에 대한 정보를 확인할 수 있다.

1
2
> pd.get_option('min_rows')
100

get_option은 옵션 이름의 일부만 일치해도 된다.

1
2
> pd.get_option('min_r')
100

max_rows 수를 설정한다. set_option도 일부만 일치해도 된다.

1
2
3
4
5
6
> pd.set_option('max_rows', 20)
> pd.options.display.max_rows
20
> pd.set_option('max_r', 50)
> pd.options.display.max_rows
50

- 컬럼의 폭 조정

display.max_colwidth 는 보통 50~70자 정도 정해져 있다. 컬럼에 표시되는 텍스트가 50자가 넘으면 ... 줄임 표시가 나타난다.

1
2
> pd.options.display.max_colwidth
50

- chop_threshold

chop_threshold 는 값의 크기 한계를 지정해서 이 값보다 작은 수는 모두 0으로 표시한다.

1
2
3
4
5
6
> pd.options.display.chop_threshold = 0.99
> pd.DataFrame({'x': [10, 1, 0.1]})
> print(x)
0 10.0
1 1.0
2 0.0

숫자 포매팅

다양한 사례는:

- float_format

float_format 는 실수 값을 출력시 소수점의 출력의 정밀도를 조정할 수 있다. 아래 람다 함수 lambda x: f'{x:.1f} 는 실수 x를 받아 소수점 첫째 자리까지 출력해 준다.

1
2
3
4
> pd.options.display.float_format = lambda x: f'{x:.1f}'
> pd.DataFrame({'x': [3.141592]})
x
0 3.1

또한 set_option 을 사용할 수 있다.

1
> pd.set_option('display.float_format', '{:.2f}'.foramt )

금액 단위에 사용하는 천단위 구분을 위해서 {:,.2f} 형식을 사용하면 화폐 단위를 추가하고 천단위 구분자를 추가해 주고 소수점 2자리수 정밀로를 지정한다.

1
2
3
4
5
> pd.set_option('display.float_format', '${:,.2f}'.format )
> pd.DataFrame({'x': [10000000.0, 34589234.4]})
x
0 $10,000,000.00
1 $34,589,234.40

- precision

실수의 소수점은 precision 로 과학적 표기법으로 변환할 자릿수를 지정한다. 아래와 같이 하면 소수점 셋째 자리 밑으로는 과학적 표기법으로 표시합니다.

1
2
3
4
> pd.options.display.precision = 3
> pd.DataFrame({'x': [0.5], 'y': [0.0005]})
x y
0 0.5 5.000e-04

과학적 표기법으로 3.000e-04는 3.000 이다. 자릿수가 아주 작거나 큰 수를 표기할 때 유용합니다.

- 설정 초기화 reset_option()

설정을 초기화할 때 사용한다.

1
2
3
4
# chop_threshold 옵션 초기화
pd.reset_option('display.chop_threshold')
# float_format 옵션 초기화
pd.reset_option('display.float_format')

- 옵션 설명 describe_option()

pd.describe_option(OPTIONS) 를 사용하면 해당 옵션에 대한 설명을 출력해 준다.

1
2
3
4
5
> pd.describe_option("max_rows")
display.max_rows : int
If max_rows is exceeded, switch to truncate view. Depending on
`large_repr`, objects are either centrally truncated or printed as
a summary view. 'None' value means unlimited.

참고

1: Try These Pandas Display Configurations

2: Pandas options

Python - 파이썬 프로젝트 패키징과 배포하기

파이썬에서 작업한 소스를 공개/비공개 배포하기 위해서 패키징을 하는 방법을 요약, 정리했다.

파이썬 모듈 배포하기

이 글은 setuptools, builds 그리고 PyPI 업로드를 위한 twine 를 사용하고 있다.

[핵심 용어]

  • PyPi, Python Package Index: 파이썬 사용자를 위한 오픈소스 패키지의 공개 저장소 일명 PyPi
  • PyPa, 파이썬 패키징 위원회: 표준 패키징 도구/메타 데이터/파일 형식 표준을 GitHub 와 Bitbucket 을 통해서 여러 패키징 도구, 문서, 이슈 추적기를 관리하고 있다.
  • distutils: 1998년/파이썬 표준 라이브러리 최초의 빌드 및 배포 시스템. 대부분 직접 사용이 단계적으로 폐지되고 있다.
    • distutils는 파이썬 3.10부터 deprecated, 3.12에서 삭제될 예정.
  • setuptools : 2004 공개/ distutils 의 드롭인(drop-in) 대체품. distutils 와 큰 차이는 다른 패키지에 대한 의존성을 선언할 수 있다.
  • [pyproject.toml]: 2016년 setuptools의 메타 파일 setup.py 의존성을 피하고자 독립한 빌드용 선언적 메타정보 파일.
  • wheel: distutils/setuptools 에 bdist_wheel 명령을 추가하는 프로젝트이다. 파이썬 라이브러리를 바이너리 확장을 포함/크로스 플랫폼 바이너리 패키징 형식 지원 (“휠”,”휠 파일”, PEP 427 정의).

도구 설치

setuptools 기반 배포도구 설치

1
python -m pip install setuptools wheel twine

파이썬 패키징

https://packaging.python.org/en/latest/tutorials/packaging-projects/ 내용을 요약, 정리, 보충한다.

프로젝트 생성

패키징 수행하면 별도의 가상환경을 생성해서 진행한다.

프로젝트를 패키징하는 과정을 위해서 packaging_tutorial 폴더 아래에 같은 구조를 갖는다.

1
2
3
4
5
packaging_tutorial/
└── src/
└── example_package_YOUR_USERNAME_HERE/
├── __init__.py
└── example.py
  • example_package_YOUR_USERNAME_HERE : 프로젝트 이름이고 중복하지 않게 한다.
  • __init__.py : 빈 파일로 폴더를 패키지로 인식하게 한다.
  • example.py : 모듈.

example.py 모듈 소스.

1
2
def add_one(number):
return number + 1

패키징용 파일 생성

배포를 위한 프로젝트의 구성을 위해 패키징에 필요한 파일을 추가한 구조는 아래 같다.

1
2
3
4
5
6
7
8
9
packaging_tutorial/
├── LICENSE
├── pyproject.toml
├── README.md
└── src/
│ └── example_package_YOUR_USERNAME_HERE/
│ ├── __init__.py
│ └── example.py
└── tests/
  • LICENSE : 라이센서 선언
  • pyproject.toml : 프로젝트 배포 프로젝트 생성에 사용하는 프론트엔드 빌드도구 pip, 백엔드 밸드도구 build
  • README.md
  • tests/ : 테스트 파일용 공간. Leave it empty for now.

패키징의 프론트엔드, 백엔드는 참조의 5번 항목을 살펴보자.

pyproject.toml 구성

보통 파일 내용은 아래 항목으로 구성한다. 이 파일은 TOML 형식의 구조를 따르고 있다. 여기에 대해서는 아래 참조 4번 항목 내용을 보기 바란다.

1
2
3
4
5
6
7
8
9
[build-system]
...

[project]
...

[project.urls]
...

빌드 도구를 명시하는 명세서 pyproject.toml에 setuptools 를 사용한 예이다.

1
2
3
[build-system]
requires = ["setuptools>=61.0"]
build-backend = "setuptools.build_meta"
  • requires : 빌드용 도구 지시.
  • build-backend : 프론트엔드 (pip)에서 빌드에 사용하는 백엔드 도구

다음은 Hatching 이란 빌드 도구를 사용한 예이다.

1
2
3
[build-system]
requires = ["hatchling"]
build-backend = "hatchling.build"

메타 정보를 포함한 간단한 pyproject.toml 구성 결과.

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
[build-system]
requires = ["setuptools>=61.0"]
build-backend = "setuptools.build_meta"

[project]
name = "example_package_YOUR_USERNAME_HERE"
version = "0.0.1"
authors = [
{ name="Example Author", email="author@example.com" },
]
description = "A small example package"
readme = "README.md"
requires-python = ">=3.7"
classifiers = [
"Programming Language :: Python :: 3",
"License :: OSI Approved :: MIT License",
"Operating System :: OS Independent",
]

[project.urls]
"Homepage" = "https://github.com/pypa/sampleproject"
"Bug Tracker" = "https://github.com/pypa/sampleproject/issues"

자세한 메타 정보 내역은 프로젝트 메타정보 정의를 참조한다. 주요 메타 정보의 인자:

  • [project]:
    • requires-python : 패키지가 요구하는 최소 파이썬 버전 명시
    • classifiers: pip가 인지하는 패키지에 대한 정보

README.md / LICENSE 파일

README.md 파일에 패키지 모듈를 설명한다.

1
2
3
4
5
# Example Package

This is a simple example package. You can use
[Github-flavored Markdown](https://guides.github.com/features/mastering-markdown/)
to write your content.

LICENSE 파일에 저작권을 명시한다.

1
2
3
Copyright (c) 2018 The Python Packaging Authority

Permission is hereby granted, free of charge, to any person obtaining a copy

배포 묶음 생성하기

배포를 위한 build 도구를 설치한다.

1
python3 -m pip install --upgrade build

packaging_tutorial 폴더 아래 pyproject.toml 파일이 있는 위치에서 배포를 위한 build 명령으로 소스를 패키징을 한다.

build 를 수행하면 별도의 venv 가상환경을 생성해서 의존성에 명시된 setuptools 등을 설치하고 빌드를 진행한다.

1
2
3
4
5
6
7
> python3 -m build
* Creating venv isolated environment...
* Installing packages in isolated environment... (setuptools>=61.0)
...
...
removing build\bdist.win-amd64\wheel
Successfully built example_package_YOUR_USERNAME_HERE-0.0.1.tar.gz and example_package_YOUR_USERNAME_HERE-0.0.1-py3-none-any.whl

이 명령의 결과로 dist 폴더에 우리 프로젝트에 대한 배포용 패키징으로 소스 패키징 .gz 파일, built distribution 패키징 .whl 2개의 파일이 생성된다.

1
2
3
dist/
├── example_package_YOUR_USERNAME_HERE-0.0.1-py3-none-any.whl
└── example_package_YOUR_USERNAME_HERE-0.0.1.tar.gz

pip 로 wheeels 설치하기

pip 에서 built distribution 파일을 직접 설치할 수 있다. installing-from-wheels 참조.

다음은 우리 프로젝트의 wheel 패키징을 설치한다.

1
python -m pip install example_package_YOUR_USERNAME_HERE-0.0.1-py3-none-any.whl

혹은 provides_extras 메타 정보를 사용해 추가 설치를 한다면,

1
python -m pip install './somepackage-1.0-py2.py3-none-any.whl[my-extras]'

Upload

처음 PyPi 에 업로드를 하려면 아래 2가지 단계를 거쳐서 진행해 본다.

  1. https://test.pypi.org/account/register/ 에서 등록
    1. 실제 pypi 가 아닌 튜토리얼과 테스트를 위한 곳.
  2. PyPi 업로드를 완성하려면 PyPI API token 을 발급받아야 한다.
    1. https://test.pypi.org/manage/account/#api-tokens

PyPI에 업로드가 완료되면 pip 를 통해서 패키지를 설치할 수 있다. 업로드를 위해서 Twin 패키지를 설치하고 사용해야 한다.

1
python3 -m pip install --upgrade twine

twine 모듈을 사용해서 dist/ 아래의 모든 소스/휠 패키징 묶음을 업로드할 수 있다. 지금은 testpypi 에 업로드를 해보자.

1
python3 -m twine upload --repository testpypi dist/*
  • 업로드시 username은 __token__ 사용.
  • 패스워드는 발급받은 pypi- 으로 시작하는 token 값.

업로드 진행은 아래 같을 것이다.

1
2
3
4
5
6
7
Uploading distributions to https://test.pypi.org/legacy/
Enter your username: __token__
Uploading example_package_YOUR_USERNAME_HERE-0.0.1-py3-none-any.whl
100% ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 8.2/8.2 kB • 00:01 • ?
Uploading example_package_YOUR_USERNAME_HERE-0.0.1.tar.gz
100% ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 6.8/6.8 kB • 00:00 • ?

여기서 repository로 testpypi 를 지정했으므로 업로드한 결과는 다음 같이 확인할 수 있다.

  • https://test.pypi.org/project/example_package_YOUR_USERNAME_HERE

저장소에서 설치하기

위에 testpypi 에 업로드한 패키지를 설치하려면 아래 같이 --index-url 로 저장소를 지정해서 사용한다.

1
python3 -m pip install --index-url https://test.pypi.org/simple/ --no-deps example-package-YOUR-USERNAME-HERE

PyPI 에 업로드

마지막으로 실제 패키지를 PyPI에 업로드하려면 https://pypi.org 등록을 하고, 등록한 사용자 아이디를 사용하고 --repository 인자를 제외하고 업로드하면 된다.

1
python3 -m twine upload dist/*

통합 메타 정보로서 pyproject.toml 활용

테스트, 코드 포맷팅 등에 대한 정보로 활용한다. 대표적으로는 코드 포맷팅 도구인 black, 테스트용 프레임워크인 pytest 등이 pyproject.toml에 설정 값을 저장하고 있다 - 파이썬 패키징의 역사, blog

1
2
3
4
5
# pyproject.toml of black
[tool.black]
line-length = 88
target-version = ['py36', 'py37', 'py38']
include = '\.pyi?$'

다음

이후에 다른 빌드 도구들, 테스트 도구들을 다뤄보자.

참고

  1. 파이썬 모듈 배포하기, python.org
  2. Tool recommendations, python.org
    1. 주요 패키징에 필요한 도구 안내
  3. 파이썬 패키징의 역사, blog
  4. TOML의 이해와 기본 활용, itworld
  5. Python package의 build frontend 와 backend

pyfolio

pyfolio 는 2023-06: pyfolio 업그레이드 안되고 있어서…

iteritems()

Pandas 의 DataFrame.iteritems 메서드가 Deprecated since version 1.5.0 상태이다.

pf.create_simple_tear_sheet(portfolio_returns)

1
2
3
pyfolio\tears.py:359,
...
AttributeError: 'Series' object has no attribute 'iteritems'

perf_stats[column].items() 로 변경했다ㅏ.

to_pydatetime error

pf.create_returns_tear_sheet(portfolio_returns)

https://stackoverflow.com/questions/63554616/ 에 설명 894, 897, 901 라인을 수정.

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23

I met the same question in my huawei laptop,but it's ok in my Surface. I solved this problem by following corrections.

On line 894, replace

valley = np.argmin(underwater)
with

valley=underwater.index[np.argmin(underwater)]
On line 897, replace

peak=valley = np.argmin(underwater)
with

temp1=underwater[:valley][underwater[:valley] == 0].dropna(axis=0,how='any')
peak = temp1.index[-1]
On line 901, replace

recovery=underwater[valley:][underwater[valley:] == 0]
with

temp2=underwater[valley:][underwater[valley:] == 0].dropna(axis=0,how='any')
recovery = temp2.index[0]

그리고 1006 라인 의 peak.to_pydatetime()

1
2
3
4
5
6
7
8
9
pyfolio\timeseries.py:1008, in gen_drawdown_table(returns, top)
1006 df_drawdowns.loc[i, 'Peak date'] = (peak.to_pydatetime()
1007 .strftime('%Y-%m-%d'))
-> 1008 df_drawdowns.loc[i, 'Valley date'] = (valley.to_pydatetime()
1009 .strftime('%Y-%m-%d'))
1010 if isinstance(recovery, float):
1011 df_drawdowns.loc[i, 'Recovery date'] = recovery

AttributeError: 'numpy.int64' object has no attribute 'to_pydatetime'

1008 라인
1
2
3
(peak).strftime('%Y-%m-%d')
(valley.strftime('%Y-%m-%d')
(recovery).strftime('%Y-%m-%d')

pd.to_datetime(peak)
pd.to_datetime(valley
pd.to_datetime(recovery)

Python 에서 secret 키 값 이용하기 - json

크롤링, 데이터 베이스 연결등에 사용자 인증번호를 사용하는데 코드 자체에 아이디/비밀번호를 입력해서 사용하면 유출의 염려가 있으므로 이를 외부 파일에 두고 관리하고자 한다.

여러가지 방법이 있겠지만 여기서는 json 을 사용한다.

key:value 형식의 properties, 윈도우 ini 같은 형식을 지원하는 configparser 모듈도 좋은 선택 같다.

json 이용 키 관리

외부에 아래 형식의 secret 파일을 생성한다.

  • 디렉토리: .api_keys/ 폴더 사용
  • 파일: secret_keys.json

secret_keys.json

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
{   "naver.com" : {
"userid": "UR_ID",
"password" :"votmdnjem" },
"apple.net": {
"userid": "UR_ID",
"password" : "votmdnjem" },
"api.twitter.com": {
"CONSUMER_KEY" : "unJgTOc0aZkk7NoX4LlD5g",
"CONSUMER_SECRET":"uHdmctDcPM66s9OasrKnr2x3pu88",
"ACCESS_TOKEN" : "98948674-J9auHiBiOGoWUJOzRafp",
"ACCESS_TOKEN_SECRET" : "kKgT9tlSY2rCIAbWJrCEEiTsR37" },
"my_database" : {
"userid" : "UR_ID",
"password" : "votmdnjem"}
}

파일 사용

json 모듈을 사용해서 해당 파일을 읽으면 키:값 형식으로 참조해서 사용할 수 있다.

1
2
3
4
import json

with open('../../.api_keys/secret_keys.json') as f:
secrets = json.loads(f.read())

이렇게 읽어들인 json 은 dict 같이 사용할 수 있다.

1
DB_USER, DB_PW = secrets['my_database']['userid'], secrets['my_database']['password']

pip/conda Proxy 사용하기

회사 등에서 방화벽을 사용하는 경우 pip / conda 저장소에서 패키지 설치가 안되는 경우가 있다. 또한 방화벽 안에서 설치할 경우 SSL verification error 에러 발생으로 설치가 안되기도 한다. 이런 경우 직접 pip 혹은 conda 설치가 안되는 경우에 프락시 지정을 해서 사용이 가능하다.

conda proxy

.condarc 파일과 conda 명령 옵션으로 사용할 수 있다.

.condarc 파일

사용자 홈디렉토리 .condarc 파일에 proxy 구성을 한다.

파일에 proxy_servers 구성해 사용한다.

1
2
3
proxy_servers:
http: http://IP_ADDRESS:8080
https: https://IP_ADDRESS:8080

ssl_verify: SSL verification error

방화벽 때문에 파이썬 패키지를 설치할 때 SSL 인증 오류(SSL verification error)가 생겨 곤란할 때가 있다. 만약 프락시 인증서가 필요하면 pip 인증서를 추가하면 ssl verification 에러를 피할 수 있다.

1
2
3
4
proxy_servers:
http: http://IP_ADDRESS:8080
https: https://IP_ADDRESS:8080
ssl_verify: %programdata%\pip\dscert.crt

conda --set 옵션 사용

설정 파일 대신 conda 명령에서 --set 옵션을 사용하면 설정 파일을 편집해서 저장이 된다.

1
conda config --set [설정내용]

다음은 ssl_verify 에 pip 인증서를 추가하거나 False 로 제외하고 사용하고 있다.

1
conda config --set ssl_verify False

명령에서 즉시 사용할 때는 --add 옵션을 사용한다.


pip proxy

pip 명령은 명려에서 옵션 pip proxy 옵션을 사용하거나 설정 파일 pip.ini 로 구성할 수 있다.

pip.ini

pip는 사용자 구성에서 아래 같이

  • 윈도우: %HOMEPATH%\pip\pip.ini
  • 리눅스/맥: $HOME/.pip/pip.conf

trusted-host 를 구성해 준다.

1
2
3
4
5
6
[global]
proxy=http://IP_ADDRESS:8080
trusted-host = pypi.python.org
pypi.org
files.pythonhosted.org

ssl cert

SSL 의 경우 cert 옵션을 사용할 수 있다.

1
2
3
4
5
6
[global]
cert=C:\Users\user\pip\cert.crt
proxy=http://IP_ADDRESS:8080
trusted-host = pypi.python.org
pypi.org
files.pythonhosted.org

pip 명령 사용

명령으로 직접 proxy 를 지정할 수 있다.

1
pip install --proxy https://{proxy}:{port} {BINARY}

다음 같인 trusted-host 등도 지정 할 수 있다.

1
pip install --upgrade --proxy https://IP_ADDRESS:8080 --trusted-host pypi.python.org --trusted-host pypi.org --trusted-host files.pythonhosted.org matplotlib numpy openpyxl xlrd xlwt pandas